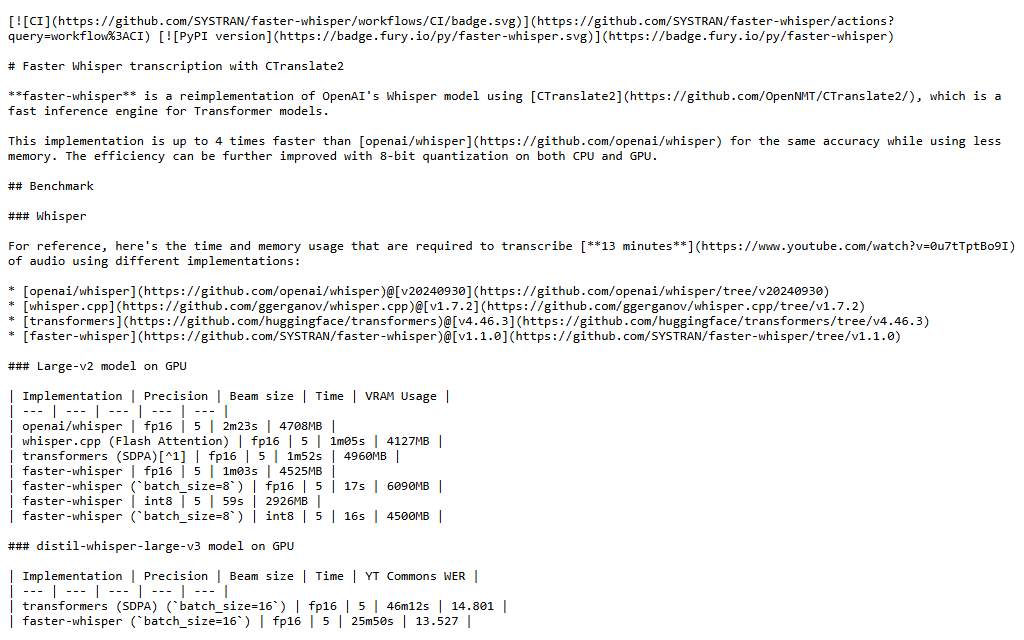
Implémentation de transcription Whisper utilisant CTranslate2 pour l’inférence locale optimisée.
L’implémentation utilise CTranslate2 et documente exécution GPU/CPU et quantification. Les performances dépendent du modèle, des réglages de décodage et du matériel.